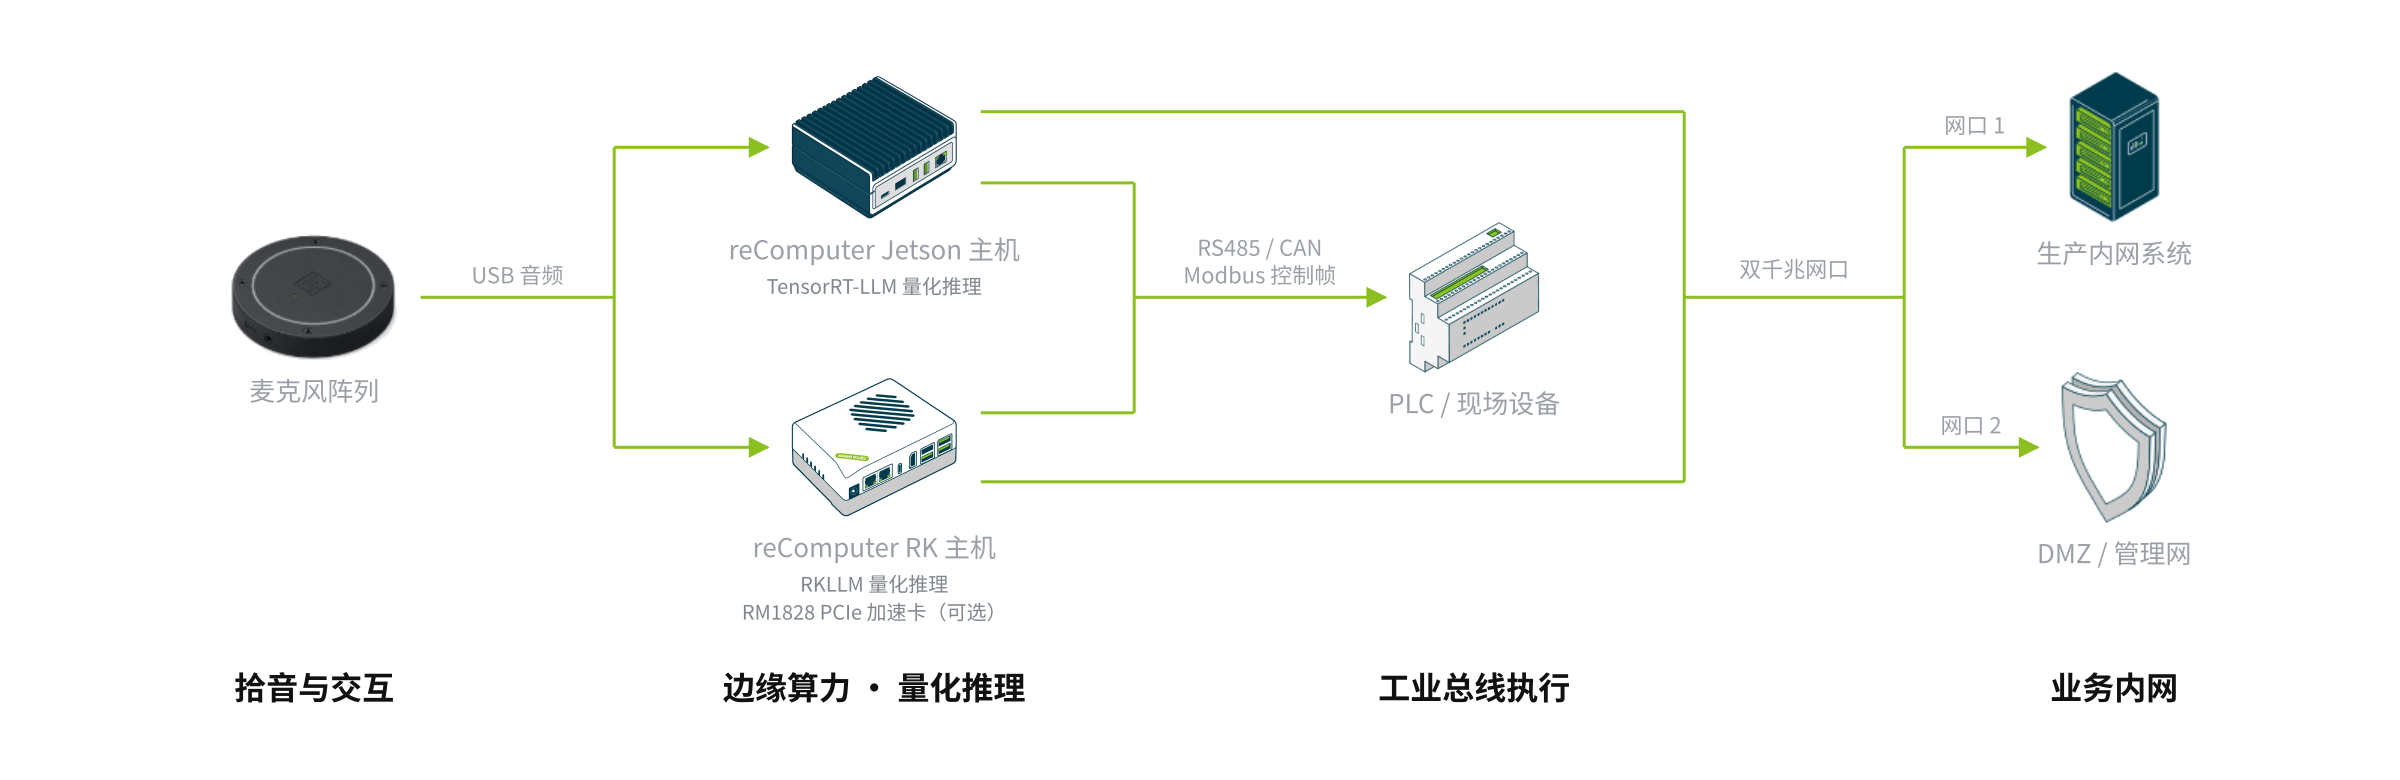
端侧大语言模型(On-Device LLM)正逐步进入工业制造、政企办公、智慧医疗与能源基础设施等物理现场。在这些场景中,将大语言模型(LLM)与语音模型(Whisper)下沉到边缘计算设备,并非追求通用大模型的宽泛百科能力,而是为了满足三项刚性工程约束:数据绝对物理不出域的隐私合规、脱离公网的毫秒级确定性响应,以及规避公有云 Token 持续计费的确定性成本结构。
然而,端侧大模型项目的落地瓶颈多数不发生在 Prompt 工程或 Agent 框架开发上,而发生在硬件算力与显存带宽的失配:将 7B 模型强行部署在共享低带宽内存的单板上导致生成速度不足 5 tok/s 无法交互,或是忽略了自回归解码(Decode)阶段的访存受限特性导致盲目追求峰值 TOPS 算力。
本文基于统一的实测基准条件(TensorRT-LLM / RKLLM),给出端侧大模型从任务分解、访存带宽评估到硬件匹配的完整选型方法,并附主流边缘计算硬件实测数据与物理级网络安全加固规范。本文设备数据均取自 Seeed 自有 reComputer 系列产品线(覆盖 2.2 TOPS 至 275 TOPS 算力区间);采用单一产品线做横向对照,旨在消除跨厂商评测中由于散热设计、供电模式、量化内核与驱动版本不一致带来的对比误差。文中所述选型方法与推导逻辑与具体品牌无关,通用适用于各类边缘系统。
结论速查:一分钟设备与模型选型矩阵
以下为后文推导的选型矩阵汇总。测试条件统一为:INT4 量化(AWQ 或 W4A16)、Power Mode = MAXN、输入 512–2048 tokens、生成 128 tokens。
| 业务任务与画像 | 推荐型号 | 核心算力与架构 | 统一内存与带宽 | 推荐模型与量化 | 实测解码吞吐 | 参考采购区间 | |
|---|---|---|---|---|---|---|---|
 | 超低功耗单工位指令解析 | reComputer RK3576 | 2.2 TOPS (RK3576 NPU) | 4GB / 8GB LPDDR5 | Qwen2.5-0.5B / 1.5B (W4A16) | 0.5B: 35.2 tok/s;1.5B: 19.6 tok/s | 约 $160–210 |
 | 边缘智能设备与 HMI 中控 | reComputer RK3588 | 6.0 TOPS (RK3588 3-Core) | 8GB / 16GB LPDDR4x | Qwen2.5-1.5B / 3B (W8A8/W4A16) | 1.5B: 16.5 tok/s;3B: 11.5 tok/s | 约 $280–360 |
 | 轻量级端侧助手与小参数 RAG | reComputer J3011 | 40 TOPS (Orin Nano 8G) | 8GB UMA (68 GB/s) | Qwen2.5-1.5B / 3B (INT4-AWQ) | 1.5B: 38.5 tok/s;3B: 22.5 tok/s | 约 $600–1000 |
 | 企业级知识库与语音中枢(主力) | reComputer Super J4012 | 100 TOPS (Orin NX 16G) | 16GB UMA (102.4 GB/s) | Qwen2.5-7B / Llama-3.1-8B (INT4) | 7B: 22.5 tok/s;8B: 23.5 tok/s | 约 $900–1800 |
 | 高带宽 7B 专用推理加速 | RK3588 + RM1828 加速卡 | 3D-Stacked NPU 芯片 | 1 TB/s 堆叠显存 | Qwen2.5-7B / ChatGLM3-6B (W4A16) | 7B: 50–61 tok/s(Prefill: 800+) | 主机 ~$280+;加速卡另询 |
 | 多模态大模型与多工位聚合中枢 | reComputer J5012 | 275 TOPS (AGX Orin 64G) | 64GB UMA (204.8 GB/s) | Qwen2.5-14B / Qwen3.5-27B (INT4) | 14B: 24.5 tok/s;27B: 14.5 tok/s | 约 $2800–4800 |
注:参考价格为单台硬件采购指导区间(采集时间:2026 年 11 月),随存储规格、散热选件与采购批量变动,最终以官方商城或销售报价为准。
三项会改变上表选型的关键边界:
- 需要同机运行 Whisper 语音识别与向量检索:必须选配统一内存 ≥ 16GB 的平台(如 Orin NX 16GB 或 RK3588 16GB 加卡)。8GB 显存设备在加载 7B INT4 模型(占用 ~5.2GB)后,剩余显存难以稳定容纳 Whisper-large-v3 与向量数据库运行时,极易触发 OOM。
- 高并发多工位同时请求:连续文本生成属于序列依赖计算。若单台设备需同时响应超过 4 路并发,建议直接采用配备 204.8 GB/s 显存带宽的 J5012,或按工位采用分布式 J4012 独立部署。
- 物理无网与高密合规环境:需选用具备模块化 M.2 Key-E 无线插槽及双物理 RJ45 网口的工业机型(如 reComputer Industrial 或 Super 系列),以满足硬件级断网合规。
🤖 向 AI 方案助手提问(基于官方选型与配件知识库):
- 终端即时查询:执行
npx @seeed-studio/solution-cli hub get on-device-lm --sections products,architecture一步查看推荐设备与硬件拓扑。- 自然语言问答:支持在 Claude Code、Codex、Antigravity、Cursor 等 AI 环境中直接提问(例如:“需要部署 Qwen2.5-7B 进行本地设备故障问答与 Modbus 指令解析,且要求物理断网,推荐哪款算力主机与配件?”),AI 助手将自动核算算力负荷并核对开箱配件。详见 solution-cli 官方文档与安装指南。
- 方案落地页预览:更多实时对比数据与产品规格详见 端侧生成式 AI 与本地大模型方案。
💡 关联方案与落地工程引用: 本文技术体系作为基础端侧算力底座,已直接接入并赋能以下行业方案与可部署参考设计:
- 行业方案:对话式语音 AI 方案、现场人机语音交互方案、智能仓储管理方案。
- 工程可部署方案:对话式语音 AI 参考设计、智能工牌交接班转写方案。
为什么将大模型部署在端侧
端侧闭环架构:从物理麦克风拾音、本地 Whisper 转写、量化 LLM 推理到 Modbus 工业总线控制
相比调用公有云 API,端侧大模型在工业与企业现场的核心差异体现在四处:
- 数据绝对不出物理局域网:工控操作日志、医疗问诊对话、涉密研发图纸及商业合同,全程在设备本地内存完成分词、推理与向量检索,物理上不接入因特网,满足各行业数据出境与隐私合规要求。
- 毫秒级确定性首字延迟(TTFT):公有云 API 受制于互联网链路往返时延(RTT)及服务器并发队列排队,首字延迟往往在 800ms 至数秒之间波动。端侧推理消除公网传输,首字生成延迟稳定在 35ms 至 150ms 区间,可满足工业实时交互需求。
- 断网工况下的业务连续性:在远洋船舶、地下矿井、偏远变电站或因突发故障断网的厂区,端侧大模型依然保持正常运转,核心控制逻辑与文档问答不中断。
- 规避按 Token 计费的不可控运营成本:公有云 API 采用持续按量计费,面对现场数千工位 7×24 小时高频次交互,长期累积成本高昂。端侧部署属于一次性硬件资产投入,投产后边际调用成本为零。
边缘算力选型四步法
在评估边缘算力之前,需通过四步明确系统边界:
第一步:按任务确定模型参数规模
端侧大模型的参数量直接决定了其语义理解能力与显存开销:
- 0.5B – 1.5B(边缘控制与意图抽取):适合单一意图分类、关键词槽位提取、简短设备控制指令转换(如“关闭 2 号输送带并启动冷却泵”转换为 JSON 结构体)。该规模可在超低功耗单板(如 RK3576 / RK3588 原生 NPU)上全速运行。
- 3B – 4B(轻量多轮问答与摘要):具备基础的上下文关联与逻辑推理能力,适合工位轻量助理、多轮故障引导排查与设备状态摘要。
- 7B – 8B(企业级黄金平衡点):当前落地应用最广泛的基座参数量(如 Qwen2.5-7B、Llama-3.1-8B)。具备成熟的代码生成、工具调用(Function Calling)、长文本理解与复杂业务逻辑推理能力,结合本地向量检索(RAG)即可胜任绝大多数企业内部知识库问答。
- 14B – 27B(高精度复合推理):适合处理长达数十页的专业技术规范、法律条款对比与深层归因。需要配备 64GB 统一内存的顶级边缘平台(如 reComputer J5012 / AGX Orin 64GB)。
第二步:识别“显存带宽墙”(Memory-Bandwidth Bound)
大模型推理包含两个阶段:预填充阶段(Prefill / Prompt 阶段) 与 解码生成阶段(Decode 阶段)。
- Prefill 阶段主要由算力受限(Compute-Bound),峰值 TOPS 算力越高,吞吐量越大;
- Decode 阶段(自回归逐字生成)是典型的访存受限计算(Memory-Bandwidth Bound)。每次生成一个 Token,模型都需要将全部权重从内存完整读取至计算单元一次。因此,解码生成速度(tok/s)直接由硬件的内存总线带宽决定,而非单纯的算力 TOPS。
以 7B INT4 模型(约占用 4.5GB–5.2GB 显存)为例:
- 在普通板载共享 LPDDR 内存设备上,受限于共享总线带宽,解码速度通常仅在 4–11 tok/s 之间波动;
- 在具备 102.4 GB/s 内存带宽的 Orin NX(reComputer Super J4012)上,实测解码速度可达 22.5 tok/s;
- 在搭载 3D 封装堆叠内存(1 TB/s 带宽)的 RM1828 专用加速卡上,实测解码速度跃升至 50–61 tok/s。
因此,选型时不可仅看宣传算力 TOPS,必须将内存总线带宽作为首要评估指标。
第三步:量化格式的工程权衡
端侧部署首选 INT4-AWQ 或 W4A16 深度量化:
- 显存与存储减半:7B 模型 FP16 原始权重约 14GB,量化为 INT4 后仅需 4.5GB–5.2GB 显存,使 16GB 边缘主机具备容纳模型并并发其他业务的能力;
- 吞吐大幅提升:结合专用量化反量化算子(如 TensorRT-LLM CUTLASS / AWQ 内核),INT4 的生成速度相比 FP16 可获得 1.5 倍至 2.2 倍的吞吐提升;
- 精度保持优良:在常识推理、阅读理解与工业问答基准测试中,现代 AWQ 量化损失通常低于 1%,完全满足工业生产环境的精度要求。
第四步:物理存储与显存容量开销测算
部署端侧大模型系统时,必须为以下三部分预留充足容量:
- 操作系统与基础环境:Ubuntu 根文件系统、CUDA / cuDNN 驱动、容器运行时及模型推理框架(占用 15GB–25GB);
- 模型权重与分词器:一个 7B INT4 模型占用 5GB,若搭配 Whisper-large-v3 语音模型与 BGE-M3 向量嵌入模型,需额外增加 4GB–6GB;
- KV Cache 与动态显存:大模型每处理 1024 tokens 上下文均需开辟动态显存。对于 7B 模型,单路 2048 上下文约占用 0.5GB–1GB 显存。
存储选型结论:边缘主机标配的 64GB/128GB 板载 eMMC 或 NVMe 仅够操作系统运行,生产部署必须加配 512GB 或 1TB 工业级 NVMe SSD。
硬件平台实测性能与选型对照
1. NVIDIA Jetson 系列实测基准(TensorRT-Edge-LLM)
NVIDIA Jetson Orin 采用 CPU-GPU 统一内存架构(UMA),借助 TensorRT-LLM 针对 Ampere 架构(sm_87)的专用优化,可提供优异的端侧吞吐。
测试基准条件:JetPack 6.x,CUDA 12.6,TensorRT-LLM,Power Mode = MAXN,输入序列 512–2048 tokens,生成 128 tokens。
| 硬件平台 | 统一内存与带宽 | 测试模型 | 量化格式 | 运行显存 | 首字延迟 (TTFT) | 解码生成速度 | 推荐并发 | 选型建议与工程边界 |
|---|---|---|---|---|---|---|---|---|
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-0.5B | INT4-AWQ | ~0.8 GB | ~35 ms | 95.0 tok/s | 4 路 | 上限建议 3B,适合轻量低延时指令控制 |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-1.5B | INT4-AWQ | ~1.6 GB | ~58 ms | 38.5 tok/s | 2 路 | 响应速度较快,显存占用低 |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-3B | INT4-AWQ | ~2.6 GB | ~88 ms | 22.5 tok/s | 1–2 路 | 推荐上限模型,保持稳定裕量 |
| reComputer J3011 (Orin Nano 8GB) | 8GB (68 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.8 GB | ~215 ms | 12.5 tok/s | 单任务 | 显存余量小,多任务并发易出现 OOM |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-1.5B | INT4-AWQ | ~1.6 GB | ~38 ms | 58.0 tok/s | 4 路 | 边缘多路并发服务主力 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-3B | INT4-AWQ | ~2.6 GB | ~58 ms | 38.0 tok/s | 4 路 | 快速指令交互 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.2 GB | ~115 ms | 22.5 tok/s | 2 路 | 推荐主力配置,显存余量可并发 Whisper |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Llama-3.1-8B | INT4-AWQ | ~5.8 GB | ~135 ms | 23.5 tok/s | 2 路 | 复杂逻辑推理与指令解析 |
| reComputer Super J4012 (Orin NX 16GB) | 16GB (102.4 GB/s) | Qwen2.5-14B | INT4-AWQ | ~10.5 GB | ~270 ms | 11.0 tok/s | 1 路 | 高精度问答与长上下文分析 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen2.5-7B | INT4-AWQ | ~5.2 GB | ~62 ms | 45.5 tok/s | 8 路 (185 tok/s) | 边缘服务器集群中枢 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Llama-3.1-8B | INT4-AWQ | ~5.8 GB | ~55 ms | 46.0 tok/s | 8 路 (175 tok/s) | 高吞吐多工位处理 |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen2.5-14B | INT4-AWQ | ~10.5 GB | ~118 ms | 24.5 tok/s | 4 路 | 复杂行业认知与长文档 RAG |
| reComputer J5012 (AGX Orin 64GB) | 64GB (204.8 GB/s) | Qwen3.5-27B | INT4-AWQ | ~17.0 GB | ~240 ms | 14.5 tok/s | 2 路 | 支持 27B 参数本地离线运行 |
2. Rockchip RK 系列实测基准(RKNN-LLM)
Rockchip 平台在端侧大模型上呈现出两种截然不同的架构形态:原生板载 NPU 单板 与 搭载 PCIe 3D-Stacked 加速卡。
测试基准条件:RKLLM v1.2.x 与 RKLLM3,锁定最高 NPU/CPU 频率,测试标准问答生成。
| 硬件平台与加速形态 | 模型参数 | 量化格式 | 内存开销 | 首字延迟 | 解码生成速度 | 加速倍率 | 架构与选型建议 |
|---|---|---|---|---|---|---|---|
| RK3576 原生单板 (板载 2核 NPU 2.2 TOPS) | Qwen2.5-0.5B | W4A16 | ~0.9 GB | ~68 ms | 35.2 tok/s | 基准 | 整机功耗数瓦,适合嵌入工控设备就地处理指令 |
| RK3576 原生单板 (板载 2核 NPU 2.2 TOPS) | TinyLlama-1.1B | W4A16 | ~1.3 GB | ~110 ms | 21.8 tok/s | 基准 | 低功耗单任务运行 |
| RK3576 原生单板 (板载 2核 NPU 2.2 TOPS) | Qwen2.5-1.5B | W4A16 | ~1.6 GB | ~125 ms | 19.55 tok/s | 基准 | 推荐轻量级模型上限 |
| RK3576 原生单板 (板载 2核 NPU 2.2 TOPS) | Qwen2.5-3B | W4A16 | ~2.5 GB | ~230 ms | 11.45 tok/s | 基准 | 速率下降,仅适合非实时查询 |
| RK3588 原生单板 (板载 3核 NPU 6 TOPS) | TinyLlama-1.1B | W8A8 | ~1.25 GB | ~140 ms | 24.21 tok/s | 基准 | 运行轻量模型稳定流畅 |
| RK3588 原生单板 (板载 3核 NPU 6 TOPS) | Qwen2.5-1.5B | W8A8 | ~2.47 GB | ~206 ms | 16.46 tok/s | 基准 | 推荐 1.5B 作为原生单板主力模型 |
| RK3588 原生单板 (板载 3核 NPU 6 TOPS) | Qwen2.5-7B | W8A8 | ~6.2 GB | ~980 ms | 4.2 tok/s | 基准 | 受板载内存共享带宽限制,单板直接跑 7B 吞吐较低 |
| RM1828 PCIe 加速卡 (RK1828 3D-Stacked 1 TB/s) | Qwen2.5-1.5B | W4A16 | 2.5 GB | ~18 ms | 120+ tok/s | 7.3 倍 | 突破片上内存带宽瓶颈,低延迟首字响应 |
| RM1828 PCIe 加速卡 (RK1828 3D-Stacked 1 TB/s) | Qwen2.5-3B | W4A16 | 2.5 GB | ~25 ms | 87 ~ 102 tok/s | 8.5 倍 | 快速多轮对话交互 |
| RM1828 PCIe 加速卡 (RK1828 3D-Stacked 1 TB/s) | Qwen2.5-7B | W4A16 | 5.0 GB | ~65 ms | 50 ~ 61 tok/s | 12~14 倍 | 7B 模型生成达 50–61 tok/s,Prefill 达 800+ tok/s |
| RM1828 PCIe 加速卡 (RK1828 3D-Stacked 1 TB/s) | ChatGLM3-6B | W4A16 | 5.0 GB | ~60 ms | ~55 tok/s | 11.5 倍 | RAG 长上下文首字无明显卡顿 |
企业级网络物理隔离与安全加固规范
在涉密企业、金融机构、电网调度或智能制造现场,安全合规审计要求“核心业务完全物理离网,杜绝无线射频信号外泄”。基于 reComputer 硬件架构可实施三层物理级安全加固:
1. 物理无线射频剥离(RF Air-Gap)
- 硬件机理:
reComputer Super J4012 / J3011以及reComputer Industrial系列采用工业载板模块化设计,Wi-Fi 与蓝牙射频芯片均集成于独立的 M.2 Key E 扩展网卡上,主板未焊装任何贴片射频芯片。 - 加固实施:
- 出厂定型:可直接订购纯有线版本(预留空插槽,不随附无线网卡);
- 现场加固:针对已有设备,松开机壳螺丝即可拔除 M.2 Key E 网卡,在硬件物理层面完全消除无线监听、假基站渗透与射频辐射泄露风险。
2. 双物理独立千兆网卡的内外网分立(Dual-LAN DMZ)
- 硬件独立性:设备配备两个独立的物理 RJ45 以太网控制器(分别对应独立 MAC 与 PHY 芯片,非单芯片虚拟分流),在硬件底层保持两条完全隔离的网络数据通道。
- 隔离拓扑配置:
- LAN 1(生产工控专网):分配私有静态 IP,直连现场 PLC 控制器、工业传感器或内网存储。严格禁止配置默认网关(Default Gateway),从 IP 协议栈层面杜绝外网寻址;
- LAN 2(受限管理网 / DMZ):直连物理硬件防火墙,仅开放受白名单限制的 SSH 运维端口或内部推理 API;
- 内核阻断转发:系统底层固定配置
net.ipv4.ip_forward = 0,确保两张物理网卡之间数据天然隔绝,外部网络流量无法穿透至生产专网。
3. 安全引导与全离线物理运维(Secure Boot & Air-Gapped Maintenance)
- 硬件级 Secure Boot:NVIDIA Jetson 模块内置硬件安全熔丝位(eFuse)。生产环节支持烧录企业私有公钥哈希,开启安全引导后,未经验证私钥签名的 Bootloader、Kernel 及根文件系统将被硬件直接拒绝加载。
- 全离线封闭更新:系统彻底关闭任何远程自动更新(OTA)后台服务。大模型权重版本更新或私有知识库同步,只能通过授权工程师在现场使用经安全扫描的物理存储介质或通过受保护的 Type-C 物理接口本地注入,杜绝远程供应链污染。
装箱清单与必需辅件检查表
在进行现场部署与工程交付前,请严格对照以下辅件清单完成配单:
- 电源适配器(关键注意项):
reComputer Super J4012 / J3011标配包装仅含主机本体,出厂不附带电源适配器。项目实施必须加配 19V 4.74A(90W)电源适配器(SKU 313080684) 及对应标准的交流电源线;reComputer Industrial R21 / J20采用接线端子供电,需由现场配电柜提供 12V–24V 工业直流供电,或选配工业导轨式导电电源模块。
- NVMe 固态硬盘:
- 主机板载的 128GB 存储仅适合操作系统与基础镜像;部署端侧大模型、Whisper 语音模型及向量数据库,必须加配 512GB 或 1TB M.2 2280 NVMe SSD。
- 工业安装件与散热风道裕量:
- 机房或机柜安装建议搭配 DIN Rail 导轨安装套件或壁挂支架;
- 运行在 MAXN 满载工况下时,算力主机进出风口需保留至少 5cm 净空距离,确保散热风道通畅。
数据来源、测试条件与工程边界说明
- 测试基准与驱动版本:
- NVIDIA 平台:JetPack 6.0 / 6.1,CUDA 12.6,TensorRT-LLM 0.12+,锁定 Power Mode = MAXN 与最高 GPU 时钟频率;
- Rockchip 平台:Linux 5.10 / 6.1,RKLLM Runtime v1.2.0 / RKLLM3,锁定 NPU 频率为最高档位。
- 测试序列长度与负载:
- 输入序列长度设定为 512–2048 tokens,输出生成长度为 128 tokens;
- 首字延迟(Time-To-First-Token, TTFT)计算自收到最后输入 Token 至吐出第一个输出 Token 的端到端耗时。
- 现场工况的工程衰减建议:
- 表中数据为实验室恒温测试结果。在现场高温(>45℃)封闭配电柜环境中,若通风不良可能触发温控降频(Thermal Throttling),导致生成速度下降 10%–20%;
- 在需要长上下文(>4096 tokens)多轮对话的场景下,KV Cache 显存占用随对话长度线性递增,请务必预留至少 2GB–3GB 显存裕量以避免 OOM 崩溃。
- 上游开源项目与基准工具链引用:
- NVIDIA TensorRT-LLM 官方项目:github.com/NVIDIA/TensorRT-LLM(用于 Jetson Orin 硬件量化编译与多卡/多流调度基准);
- Rockchip RKLLM 官方工具链:github.com/airockchip/rknn-llm(支持 RK3576/RK3588 原生 NPU 与 RM1828 专用卡转换量化模型);
- 开源基座模型:Qwen2.5 系列模型权重来自阿里通义千问开源社区,Llama-3.1 来自 Meta AI 开源社区。
五、企业级 ODM/OEM 硬件定制服务
如果在标准选型矩阵中,现有整机型号无法完全满足现场机箱空间限制、特定工业接口(如多路隔离 CAN/RS485)、特殊供电制式(9–36V 工业宽压或车载电源)、防护等级(IP66/IP67 密闭无风扇)或深度私有模型出厂预装需求,Seeed Studio 提供灵活的 ODM/OEM 硬件定制服务:
- 主板与载板定制:在 Jetson Orin 或 RK3588 核心模组基础上增减特定接口、专有传感器扩展或 PCIe 加速卡插槽;
- 工业整机与外观开模:定制企业专属配色、无风扇铝合金外壳、丝印品牌 Logo 与专属外包装;
- 系统与模型镜像预装:将调优好的 TensorRT-LLM / RKLLM 运行时、量化模型权重及本地推理服务固化出厂,实现开箱即用。
如需评估具体定制方案与批量采购,欢迎了解 Seeed Studio 硬件定制服务 或直接向方案架构师团队提交定制需求。
